

ESM-2 embedding 蛋白质同源搜索:P69905
在 BioQ 中查询 P69905(血红蛋白 α),列出 ESM-2 空间中最近的 8 个 Swiss-Prot 近邻,附余弦相似度与 UniProt 记录,数据截至 2026-11-06。
数据截至 2026年11月6日 · BioQ 团队
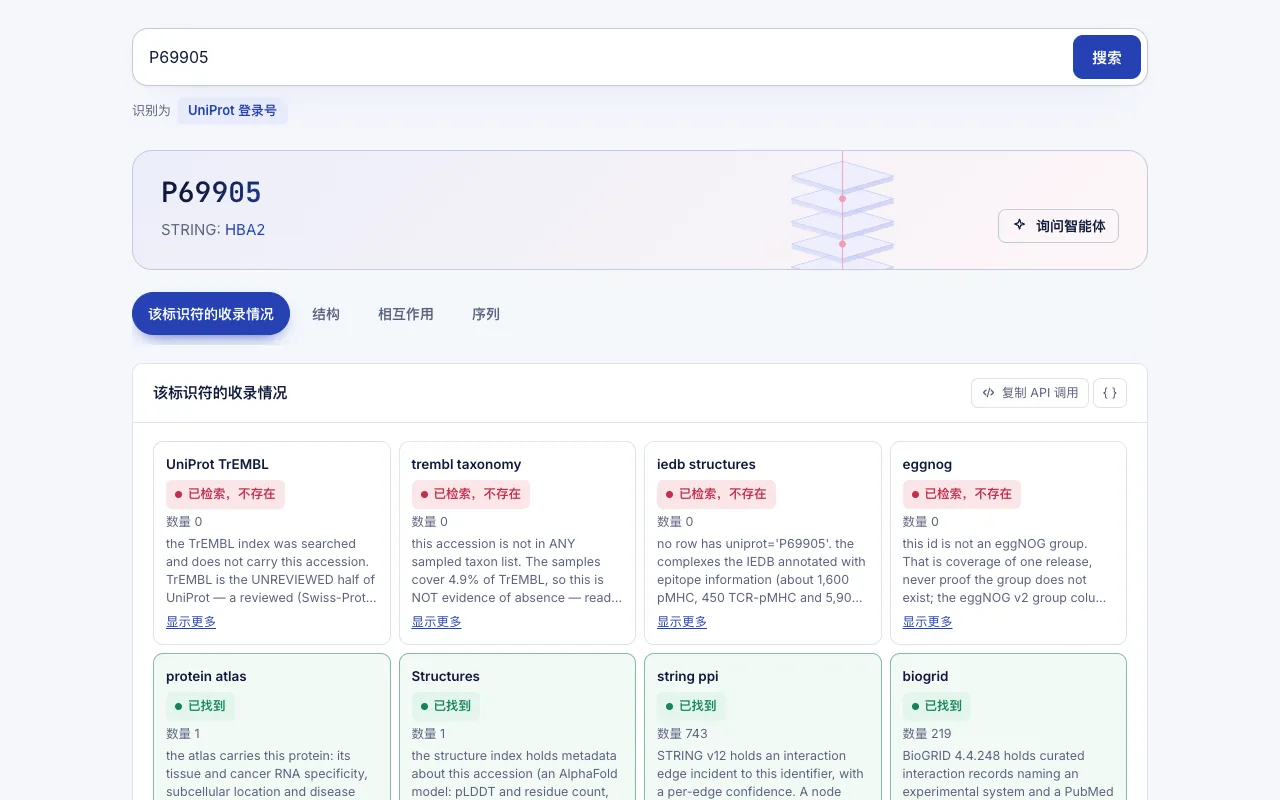
对 P69905(血红蛋白 α)在 BioQ 中做 ESM-2 embedding 蛋白质同源搜索,返回 8 个 Swiss-Prot 近邻,余弦相似度从 1.0 到 0.9992。数据截至 2026-11-06。引擎总耗时 0.45 秒,共执行 2 次查询。
我们问了什么
这是常见的任务:手头有一个蛋白,想知道 Swiss-Prot 中有没有与之相关的条目。序列比对通常是首选工具,蛋白语言模型则提供了另一个视角:每个 Swiss-Prot 条目都是嵌入空间中的一个点,列出离你的蛋白最近的那些点即可。
本例选用一个公开且广为人知的蛋白,方便你逐行核对结果。查询对象是 UniProt 登录号 P69905,即人血红蛋白亚基 α(条目名 HBA_HUMAN)。我们请求 ESM-2 空间中最近的 8 个 Swiss-Prot 蛋白,同时调取基因 HBA1 的 UniProt 记录,以便把近邻列表与人工注释条目对照阅读。
BioQ 返回了什么
近邻部分使用 Swiss-Prot 的 ESM-2 650M 嵌入向量,共显示 8 行。第一行是查询蛋白本身,这符合预期:任何蛋白最近的点都是它自己。
| UniProt 登录号 | 余弦相似度 |
|---|---|
| P69905 | 1 |
| P69906 | 1 |
| P69907 | 1 |
| Q9TS35 | 0.9996 |
| P01923 | 0.9995 |
| P63107 | 0.9992 |
| P63108 | 0.9992 |
| P67817 | 0.9992 |
有三个登录号的得分为 1.0:P69905、P69906 和 P69907。其后是 Q9TS35(0.9996)、P01923(0.9995),以及 P63107、P63108 和 P67817(均为 0.9992)。工具自带的说明在此适用:几乎所有蛋白对的余弦值都很高,它只用于对近邻排序,不是序列一致性百分比。
第二部分来自 UniProt 的基因 HBA1 查询,共有 26 条 Swiss-Prot 记录,下面是开头几行。
| 登录号 | 条目名称 | 长度(氨基酸) |
|---|---|---|
| P69905 | HBA_HUMAN | 142 |
| P01946 | HBA_RAT | 142 |
| P83270 | HBA1_ANAMI | 143 |
| Q1AGS5 | HBA1_ARCGL | 143 |
| Q1AGS9 | HBA1_BORSA | 143 |
其中 P69905 为 HBA_HUMAN,长 142 个氨基酸残基;大鼠条目 P01946(HBA_RAT)同样是 142 个残基。随后三个来自其他物种的条目长度为 143 个残基。这是一个快速的一致性检查:由基因名预期的蛋白家族确实存在于 UniProt 中,且长度与查询蛋白接近。
结果意味着什么以及如何解读
看排名,不要看数值。 所有得分都落在 0.9992 到 1.0 之间,绝对值几乎没有信息量,有价值的是排序以及列表在何处下降。像本例这样一串几乎相同的得分,只说明这些蛋白相对于 Swiss-Prot 的其余部分更接近查询蛋白,并不能说明它们在序列一致性上有多接近。
到 UniProt 条目中逐个核查近邻。 近邻表只给出登录号。请打开 P69906、P69907、Q9TS35、P01923、P63107、P63108 和 P67817,查看蛋白名称、物种和家族注释。本例的数据并未说明这些条目是什么,所以不要臆断。如果大多数近邻与查询蛋白属于同一家族,就支持家族层面的关联;如果某个近邻在名称和功能上与之无关,应视为待验证的线索,而不是结论。
MMseqs2 与 ESM-2 的区别。 MMseqs2 等比对工具会给出每个命中的一致性、覆盖度和 E-value,并可查看比对本身。蛋白语言模型的嵌入则比较整条序列的学习表示,因此即使比对信号很弱,也可能把蛋白放在相近的位置,这正是人们用它研究远缘同源的原因。两者互为补充。本结果没有在你的蛋白上对二者做比较,所以问题重要时请两种方法都运行,看它们在哪里一致。
手工流程与一次查询。 手工完成这一任务,需要在 UniProt 中查登录号,获取或生成 Swiss-Prot 的嵌入向量,计算相似度,再回到 UniProt 逐个阅读近邻。这里一次查询 P69905 就调用了 2 个不同的资源:Swiss-Prot 的 ESM-2 嵌入索引和 UniProt。引擎总耗时为 0.45 秒。该数字仅为引擎耗时,不含你阅读结果的时间,我们也不对手工流程的耗时做任何断言。
如何在 BioQ 中复现 ESM-2 embedding 蛋白质同源搜索
- 打开 BioQ,把 UniProt 登录号粘贴到搜索框。对你自己的蛋白,请使用其 Swiss-Prot 登录号。如果你只有一条新序列,近邻方法需要的是索引中已有的登录号。
- 按原样运行下面的查询。
P69905- 先读近邻表。注意余弦值从哪里开始下降,并留意你不认识的登录号。
- 打开不熟悉登录号的 UniProt 记录,将名称、物种和长度与查询蛋白对比。
- 如果某个近邻看起来值得关注,就对这一对蛋白运行 MMseqs2 等序列比对搜索,得到一致性和 E-value。然后在 BioQ 中查询该近邻的基因,看其他数据层有什么信息。
BioQ 中每个答案都会标明来源,因此你导出的表格会带有嵌入向量的版本(Swiss-Prot 的 ESM-2 650M 嵌入)以及记录的 UniProt 出处。
局限:数据未显示的内容
- 余弦相似度不是序列一致性,也不是同源的概率。本例中每个得分都很高,因此对原始数值设阈值无法区分相关与不相关的蛋白。
- 列表显示 8 个近邻,是因为请求的就是 8 个。它并不表明 Swiss-Prot 中有多少蛋白与查询蛋白相关,列表之外的蛋白仍可能相关。
- 嵌入索引只覆盖 Swiss-Prot,不在 Swiss-Prot 中的相关蛋白不会出现。
- 结果不能说明功能、结构或进化方向。相似的嵌入可能反映共有结构域、氨基酸组成或家族归属,表格并未说明是哪一种。
- 血红蛋白 α 是研究充分且高度保守的家族。表征较少的蛋白可能得到更平、更难解读的列表,本例无法预知你的蛋白表现如何。
- HBA1 的 26 条 UniProt 记录,是该基因名下返回的条目数,并不衡量该家族中存在多少种不同的蛋白。
- 数字反映的是截至 2026-11-06 的数据。UniProt 或嵌入向量的后续版本可能改变该列表。
数据与方法
本页数字于2026-11-06从 BioQ 引擎读取(共2次查询,引擎累计耗时0.5秒)。表格由代码根据引擎返回结果生成,正文只是对这些数值的转述。
/neighbourhood, /uniprot
在 BioQ 中亲自运行同一查询:P69905
仅供科研参考。本页汇总公开数据,不构成医疗建议。
BioQ 是一款以“让生物学研究提速 100 倍”为目标的 AI 搜索引擎和智能体。可在网页应用和 REST API 中使用,也可通过 MCP 在 Claude、ChatGPT、Cursor 中提问。
使用的查询
常见问题
如何用 ESM-2 embedding 查找与我的蛋白相关的蛋白?
在 BioQ 中输入 Swiss-Prot 登录号,例如 P69905,即可返回 ESM-2 空间中最近的 Swiss-Prot 蛋白;本例返回 8 个,余弦值从 1.0 到 0.9992。
余弦值等同于序列一致性百分比吗?
不等同。余弦值只用于对近邻排序,而且几乎对所有蛋白都很高。本例中 8 个值都在 0.9992 到 1.0 之间,要得到一致性需使用比对工具。
ESM-2 近邻搜索与 MMseqs2 有何不同?
MMseqs2 对序列做比对,并给出一致性和 E-value;ESM-2 搜索比较的是学习得到的嵌入,可能发现远缘同源。本例没有在你的蛋白上比较两者,所以对有价值的近邻请再用比对方法验证。
P69905 的查询用了多长时间?
引擎总耗时为 0.45 秒,共 2 次查询,调用 2 个不同的资源。这只是引擎耗时,不含阅读时间。
本结果中 HBA1 有多少条 UniProt 记录?
UniProt 部分列出基因 HBA1 的 26 条 Swiss-Prot 记录。人类条目 P69905(HBA_HUMAN)长 142 个残基。
来源
结果基于所示日期的公开数据库,可能会变化。BioQ 提供研究信息,不构成医疗建议。
更多文章
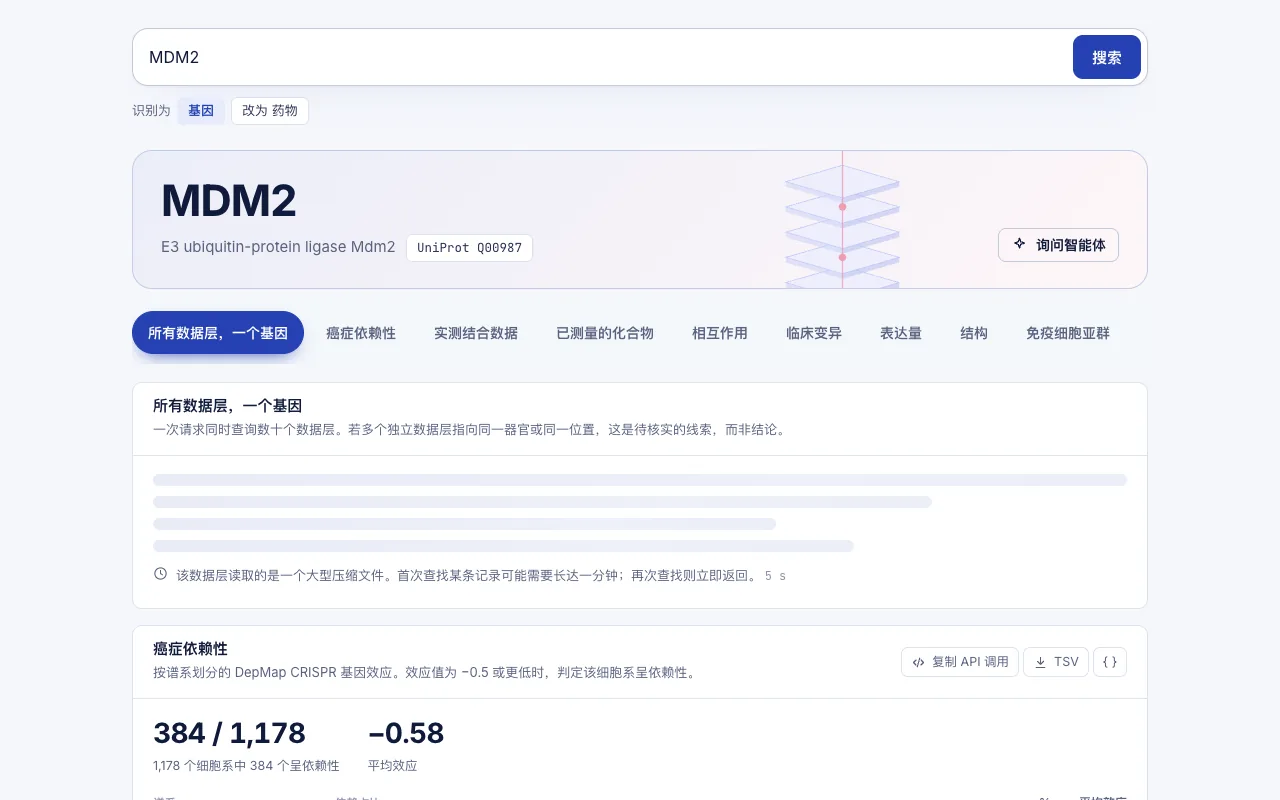
MDM2 和 MDM4 靶点对比:依赖性与药物
MDM2 和 MDM4 靶点对比:DepMap 24q4 中 1178 株细胞系里 384 株依赖 MDM2,142 株依赖 MDM4;药物 MDM2 12 种、MDM4 1 种。
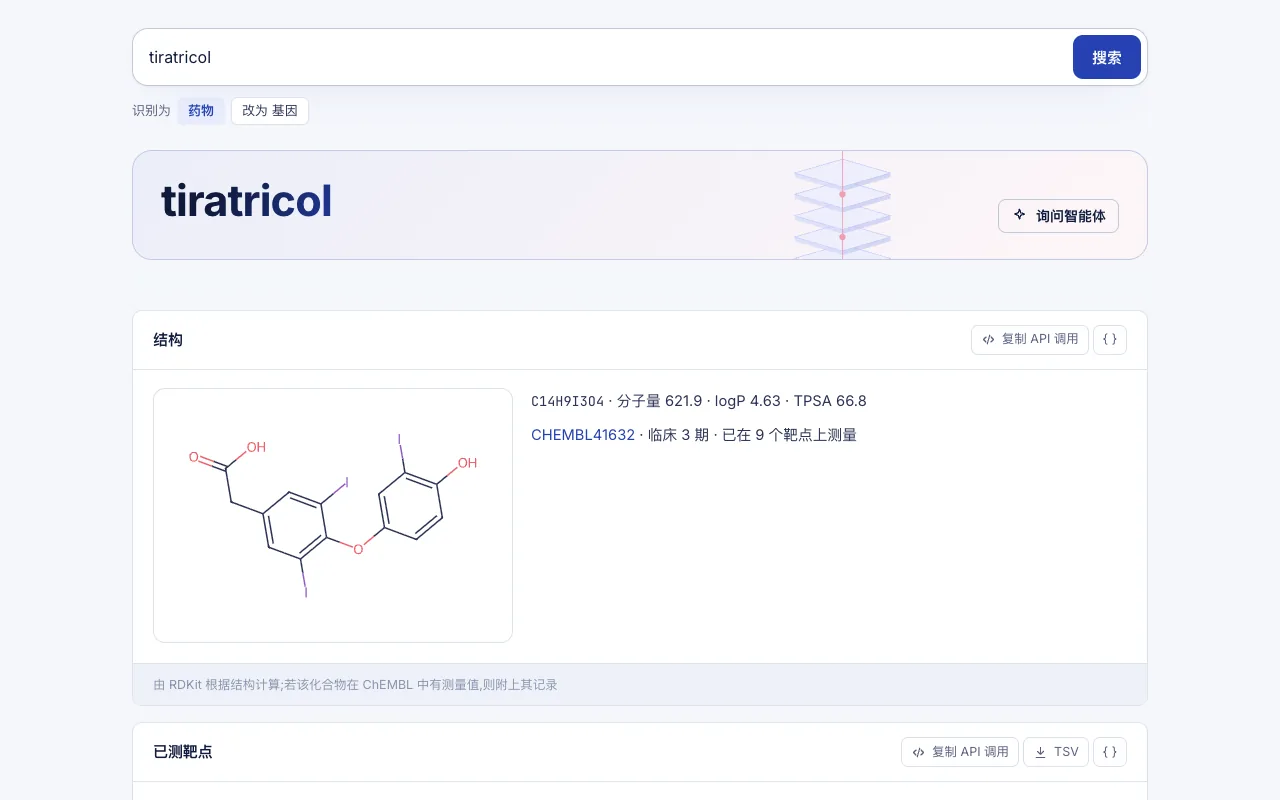
tiratricol FDA批准:靶点与活性数据(BioQ)
tiratricol FDA批准(Emcitate):ChEMBL收录68个靶点,THRB、THRA的pChEMBL最高,登记3项试验,数据截至2026-11-17。
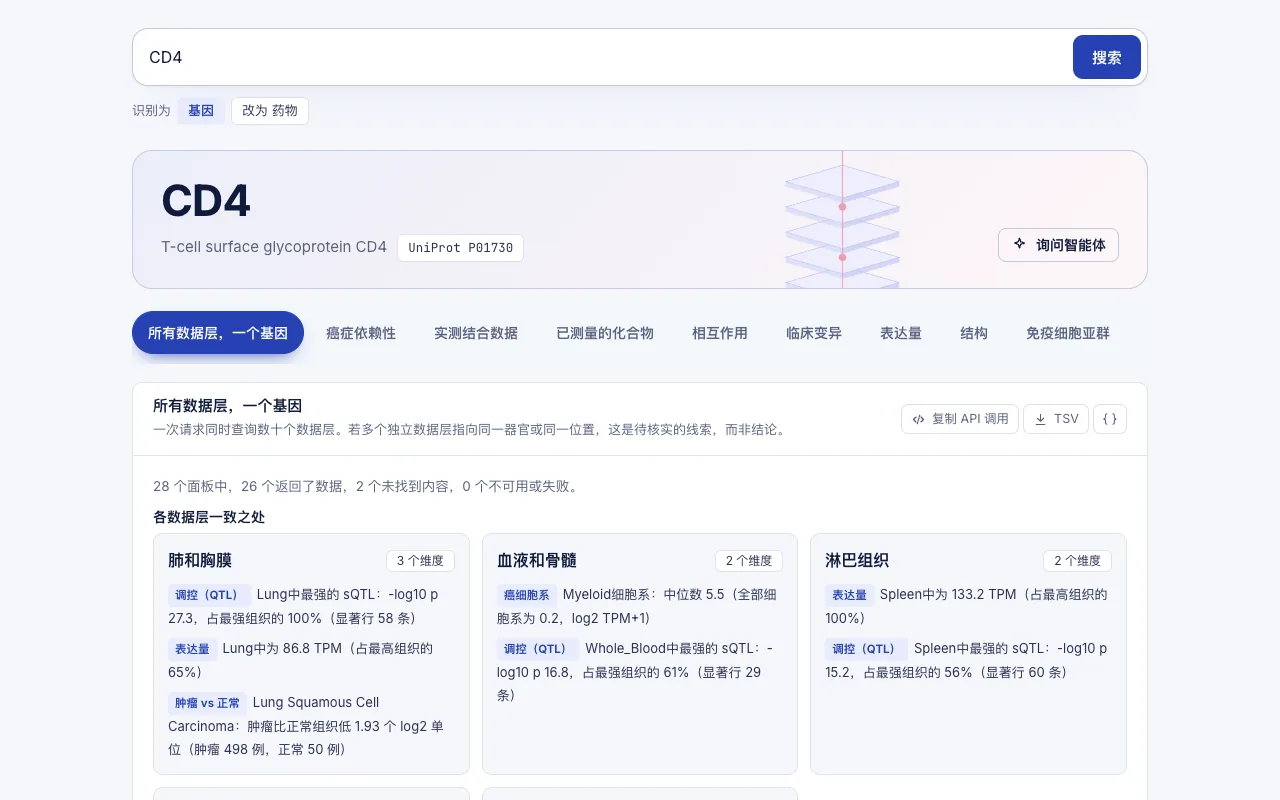
CD4 新研究:CAR-NK 细胞与 HIV 反弹的背景解读
CD4 新研究:基于 CD4 的 CAR-NK 论文与 HIV 反弹,结合 BioQ 的 DepMap 依赖性、Open Targets 疾病关联、药物和 Reactome 通路解读。