

Proteinhomologie-Suche mit ESM-2-Embedding: P69905
P69905 (Hämoglobin alpha) in BioQ abfragen: die 8 nächsten Swiss-Prot-Nachbarn im ESM-2-Raum mit Kosinus-Werten und UniProt-Einträgen, Stand 2026-11-06.
Datenstand 6. November 2026 · Das BioQ-Team
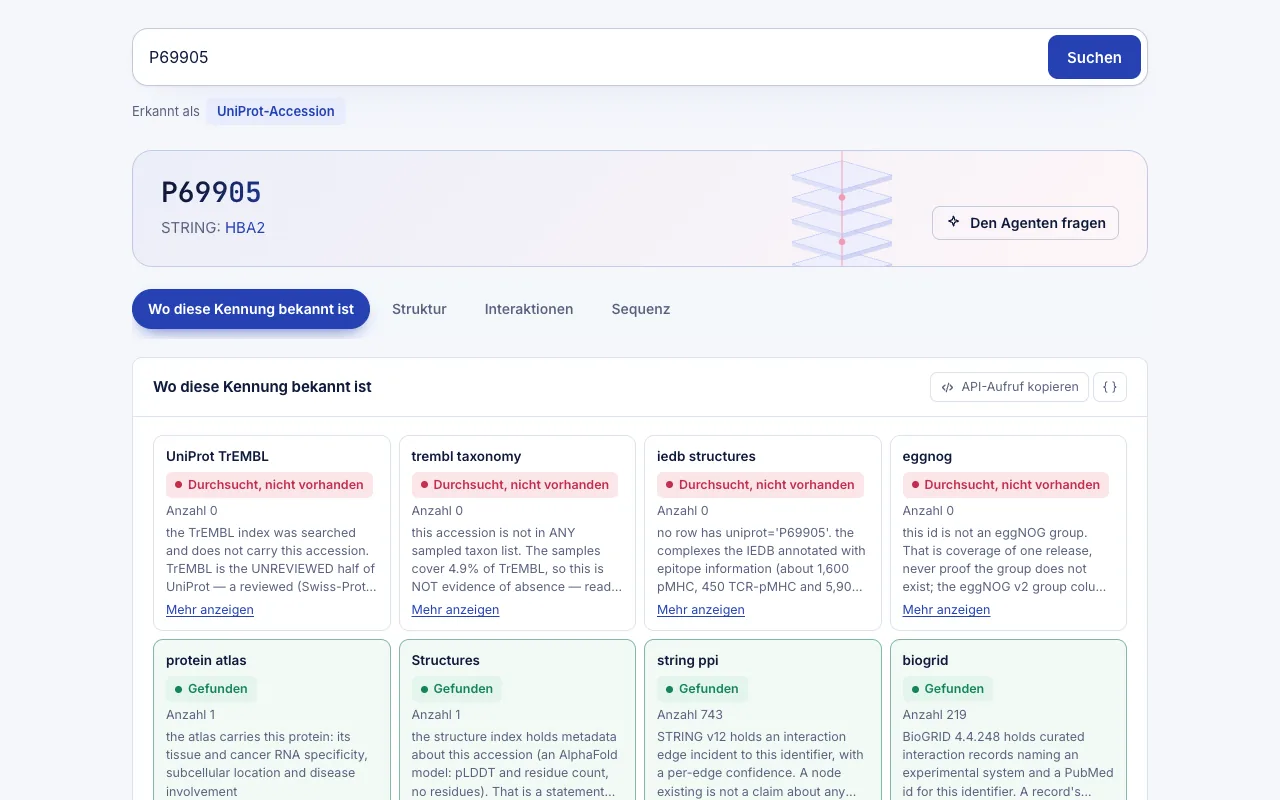
Für P69905 (Hämoglobin alpha) liefert eine Proteinhomologie-Suche mit ESM-2-Embedding in BioQ 8 Swiss-Prot-Nachbarn, deren Kosinus-Werte von 1,0 bis 0,9992 reichen. Die Daten stammen vom Stand 2026-11-06. Die Engine benötigte insgesamt 0,45 Sekunden für 2 Abfragen.
Fragestellung: Proteinhomologie-Suche mit ESM-2-Embedding
Die Aufgabe ist alltäglich. Sie haben ein Protein und möchten wissen, ob Swiss-Prot verwandte Einträge enthält. Meist liegt eine Sequenzsuche nahe. Ein Protein-Sprachmodell bietet eine zweite Sicht: Jeder Swiss-Prot-Eintrag ist ein Punkt im Embedding-Raum, und Sie lassen sich die Punkte auflisten, die Ihrem am nächsten liegen.
Dieses Beispiel verwendet ein öffentliches, gut bekanntes Protein, damit Sie jede Zeile des Ergebnisses nachprüfen können. Die Abfrage ist die UniProt-Accession P69905, also die humane Hämoglobin-Untereinheit alpha (Eintragsname HBA_HUMAN). Wir fragen nach den 8 nächsten Swiss-Prot-Proteinen im ESM-2-Raum. Zusätzlich rufen wir die UniProt-Einträge zum Gen HBA1 ab, damit sich die Nachbarliste neben kuratierten Einträgen lesen lässt.
Was BioQ zurückgibt
Der Nachbarblock nutzt die ESM-2-650M-Embeddings von Swiss-Prot und zeigt 8 Zeilen. Die erste ist die Abfrage selbst. Das ist erwartbar, denn der nächste Punkt zu jedem Protein ist dieses Protein.
| UniProt-Zugangsnummer | Kosinus-Ähnlichkeit |
|---|---|
| P69905 | 1 |
| P69906 | 1 |
| P69907 | 1 |
| Q9TS35 | 0.9996 |
| P01923 | 0.9995 |
| P63107 | 0.9992 |
| P63108 | 0.9992 |
| P67817 | 0.9992 |
Drei Accessions erreichen 1,0: P69905, P69906 und P69907. Danach folgen Q9TS35 mit 0,9996, P01923 mit 0,9995 sowie P63107, P63108 und P67817 mit 0,9992. Der Hinweis des Tools gilt hier: Ein Kosinus-Wert ist für nahezu alles hoch. Er ordnet Nachbarn in eine Rangfolge und ist keine prozentuale Sequenzidentität.
Der zweite Block stützt sich auf UniProt für das Gen HBA1. Er enthält 26 Swiss-Prot-Einträge, die ersten Zeilen sehen Sie unten.
| Zugangsnummer | Eintragsname | Länge (AS) |
|---|---|---|
| P69905 | HBA_HUMAN | 142 |
| P01946 | HBA_RAT | 142 |
| P83270 | HBA1_ANAMI | 143 |
| Q1AGS5 | HBA1_ARCGL | 143 |
| Q1AGS9 | HBA1_BORSA | 143 |
P69905 ist HBA_HUMAN mit 142 Aminosäuren, und auch der Eintrag der Ratte, P01946 (HBA_RAT), umfasst 142 Aminosäuren. Die nächsten drei Einträge aus anderen Arten haben 143 Aminosäuren. Das ist ein schneller Plausibilitätscheck: Die aufgrund des Gennamens erwartete Familie ist in UniProt vorhanden, mit Längen nahe an Ihrer Abfrage.
Einordnung und Interpretation
Lesen Sie die Rangfolge, nicht den Zahlenwert. Alle Werte liegen zwischen 0,9992 und 1,0, der Absolutwert sagt daher kaum etwas aus. Aussagekräftig sind die Reihenfolge und die Stelle, an der die Liste abfällt. Eine flache Liste nahezu identischer Werte wie diese besagt nur, dass die Proteine im Vergleich zum Rest von Swiss-Prot nahe an der Abfrage liegen. Wie nah sie in Bezug auf die Sequenzidentität liegen, sagt sie nicht.
Prüfen Sie jeden Nachbarn im UniProt-Eintrag. Die Nachbartabelle nennt nur Accessions. Öffnen Sie P69906, P69907, Q9TS35, P01923, P63107, P63108 und P67817 und lesen Sie Proteinname, Organismus und Familienannotation. Die vorliegenden Daten geben nicht an, um welche Einträge es sich handelt, nehmen Sie also nichts an. Gehören die meisten Nachbarn derselben Familie an wie Ihr Protein, stützt das eine Verwandtschaft auf Familienebene. Ist einer nach Name und Funktion nicht verwandt, behandeln Sie ihn als Hinweis, der getestet werden muss, nicht als Befund.
MMseqs2 und ESM-2. Alignment-Werkzeuge wie MMseqs2 geben für jeden Treffer Identität, Abdeckung und E-Wert an, und Sie können das Alignment selbst einsehen. Embeddings von Protein-Sprachmodellen funktionieren anders: Sie vergleichen gelernte Repräsentationen ganzer Sequenzen und können Proteine auch dann nah beieinander platzieren, wenn das Alignment-Signal schwach ist. Deshalb setzt man sie für entfernte Homologie ein. Beide Ansätze ergänzen sich. Dieses Ergebnis vergleicht sie nicht an Ihrem Protein. Führen Sie bei wichtigen Fragen beide aus und prüfen Sie, wo sie übereinstimmen.
Manueller Weg gegenüber einer Abfrage. Von Hand bedeutet diese Aufgabe: die Accession in UniProt nachschlagen, Embeddings für Swiss-Prot finden oder erzeugen, Ähnlichkeiten berechnen und dann zu UniProt zurückkehren, um jeden Nachbarn zu lesen. Hier erreichte eine Abfrage, P69905, 2 verschiedene Ressourcen: den ESM-2-Embedding-Index von Swiss-Prot und UniProt. Die Engine-Zeit betrug insgesamt 0,45 Sekunden. Diese Zahl ist reine Engine-Zeit. Sie enthält nicht die Zeit, die Sie zum Lesen der Ergebnisse brauchen, und wir treffen keine Aussage über die Dauer des manuellen Wegs.
So reproduzieren Sie die Abfrage in BioQ
- Öffnen Sie BioQ und fügen Sie die UniProt-Accession in das Suchfeld ein. Für Ihr eigenes Protein verwenden Sie dessen Swiss-Prot-Accession. Haben Sie nur eine neue Sequenz, braucht der Nachbarschaftsansatz eine Accession, die bereits im Index enthalten ist.
- Führen Sie die folgende Abfrage unverändert aus.
P69905- Lesen Sie zuerst die Nachbartabelle. Achten Sie darauf, wo die Kosinus-Werte zu fallen beginnen, und notieren Sie jede Accession, die Sie nicht kennen.
- Öffnen Sie die UniProt-Einträge der unbekannten Accessions. Vergleichen Sie Name, Organismus und Länge mit Ihrer Abfrage.
- Wirkt ein Nachbar interessant, führen Sie für dieses Paar eine Sequenz-Alignment-Suche wie MMseqs2 aus, um Identität und E-Wert zu erhalten. Fragen Sie anschließend BioQ nach dem Gen des Nachbarn, um zu sehen, was die anderen Datenebenen dazu enthalten.
Jede Antwort in BioQ nennt ihre Quelle. Die exportierte Tabelle enthält daher die Embedding-Version (ESM-2-650M-Embeddings von Swiss-Prot) und die UniProt-Herkunft der Einträge.
Grenzen: Was die Daten nicht zeigen
- Eine Kosinus-Ähnlichkeit ist keine Sequenzidentität und keine Wahrscheinlichkeit für Homologie. In diesem Beispiel ist jeder Wert sehr hoch, ein Schwellenwert auf dem Rohwert würde verwandte und nicht verwandte Proteine daher nicht trennen.
- Die Liste zeigt 8 Nachbarn, weil genau so viele angefordert wurden. Sie zeigt nicht, wie viele Swiss-Prot-Proteine mit Ihrer Abfrage verwandt sind, und ein Protein knapp außerhalb der Liste kann dennoch verwandt sein.
- Das Embedding deckt nur Swiss-Prot ab. Ein verwandtes Protein, das nicht in Swiss-Prot enthalten ist, kann nicht erscheinen.
- Das Ergebnis sagt nichts über Funktion, Struktur oder evolutionäre Richtung aus. Ähnliche Embeddings können gemeinsame Domänen, Zusammensetzung oder Familienzugehörigkeit widerspiegeln, und die Tabelle gibt nicht an, was davon zutrifft.
- Hämoglobin alpha ist eine gut untersuchte, stark konservierte Familie. Ein weniger gut charakterisiertes Protein kann eine flachere, schwerer interpretierbare Liste ergeben, und dieses Beispiel kann nicht vorhersagen, wie sich Ihr Protein verhält.
- Die 26 UniProt-Einträge zu HBA1 sind die Zahl der Einträge, die für diesen Gennamen zurückgegeben wurden. Sie messen nicht, wie viele verschiedene Proteine die Familie umfasst.
- Die Zahlen geben den Stand 2026-11-06 wieder. Spätere Versionen von UniProt oder der Embeddings können die Liste verändern.
Daten und Methode
Die Zahlen auf dieser Seite wurden am 2026-11-06 aus der BioQ-Engine gelesen (2 Abfragen, insgesamt 0.5 s Engine-Zeit). Die Tabellen erzeugt Code aus den Antworten der Engine; der Text erklärt sie nur.
/neighbourhood, /uniprot
Führen Sie dieselbe Abfrage selbst in BioQ aus: P69905
Nur für Forschungszwecke. Diese Seite fasst öffentliche Daten zusammen und ist keine medizinische Beratung.
BioQ ist eine KI-Suchmaschine und ein Agent mit einem Ziel: die biologische Forschung um das 100-Fache zu beschleunigen. Fragen Sie in der Web-App, über die REST-API oder per MCP aus Claude, ChatGPT oder Cursor.
Verwendete Abfragen
Häufige Fragen
Wie finde ich mit ESM-2-Embeddings verwandte Proteine zu meinem Protein?
Geben Sie die Swiss-Prot-Accession, zum Beispiel P69905, in BioQ ein. BioQ liefert die nächsten Swiss-Prot-Proteine im ESM-2-Raum; in diesem Beispiel waren es 8, mit Kosinus-Werten von 1,0 bis 0,9992.
Ist der Kosinus-Wert dasselbe wie die prozentuale Identität?
Nein. Der Kosinus-Wert ordnet Nachbarn nur in eine Rangfolge und ist für nahezu alles hoch. In diesem Beispiel liegen alle 8 Werte zwischen 0,9992 und 1,0, die Identität erfordert daher ein Alignment-Werkzeug.
Wie unterscheidet sich eine ESM-2-Nachbarsuche von MMseqs2?
MMseqs2 alignt Sequenzen und gibt Identität und E-Wert an. Die ESM-2-Suche vergleicht gelernte Embeddings, die entfernte Homologie erfassen können. Dieses Beispiel vergleicht beide nicht an Ihrem Protein, prüfen Sie vielversprechende Nachbarn daher mit einem Alignment.
Wie lange dauerte die Abfrage zu P69905?
Die Engine-Zeit betrug insgesamt 0,45 Sekunden, für 2 Abfragen auf 2 verschiedenen Ressourcen. Das ist reine Engine-Zeit, ohne die Zeit zum Lesen der Ergebnisse.
Wie viele UniProt-Einträge hat HBA1 in diesem Ergebnis?
Der UniProt-Block listet 26 Swiss-Prot-Einträge zum Gen HBA1 auf. Der humane Eintrag P69905 (HBA_HUMAN) ist 142 Aminosäuren lang.
Quellen
Die Ergebnisse stammen aus öffentlichen Datenbanken zum angegebenen Datum und können sich ändern. BioQ liefert Forschungsinformationen, keine medizinische Beratung.
Weitere Beiträge
MDM2 und MDM4 im Vergleich: Genabhängigkeit
MDM2 und MDM4 im Vergleich anhand von DepMap 24q4: 384 von 1178 Zelllinien hängen von MDM2 ab, 142 von MDM4; 12 Wirkstoffe zu MDM2, 1 Wirkstoff zu MDM4.
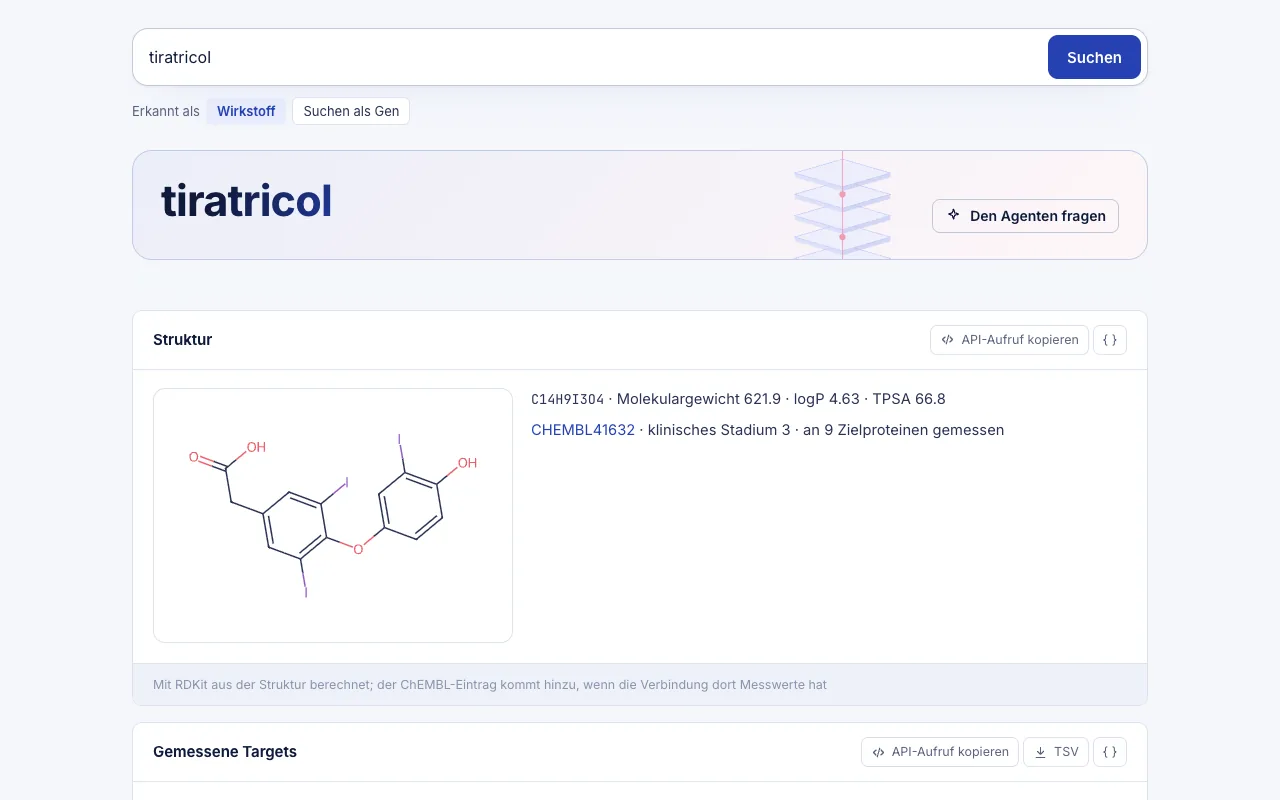
Tiratricol FDA-Zulassung: Targets und Potenz in BioQ
Tiratricol FDA-Zulassung (Emcitate): ChEMBL listet 68 Targets, THRB und THRA führen nach pChEMBL; 3 Studien in ClinicalTrials.gov. Stand 2026-11-17.
Neue CD4-Studie: CAR-NK-Zellen und HIV-Rebound
Neue CD4-Studie zu CAR-NK-Zellen und HIV-Rebound, eingeordnet mit BioQ-Daten zu CD4: DepMap-Abhängigkeit, Open-Targets-Erkrankungen, Wirkstoffe und Reactome.