

Recherche d'homologie protéique par ESM-2 : P69905
Lancez P69905 (hémoglobine alpha) dans BioQ : 8 plus proches voisins Swiss-Prot dans l'espace ESM-2, scores cosinus et fiches UniProt, données au 2026-11-06.
Données au 6 novembre 2026 · L’équipe BioQ
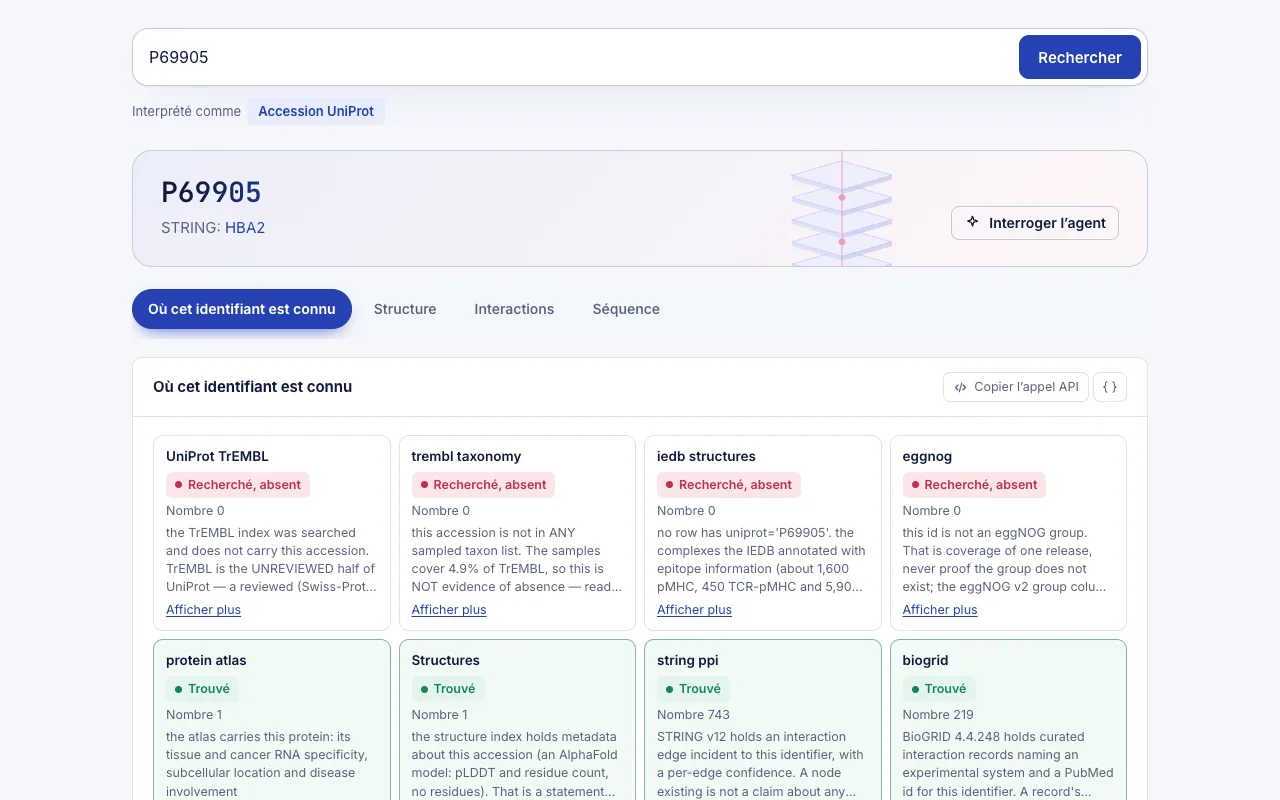
Pour P69905 (hémoglobine alpha), une recherche d'homologie protéique par embedding ESM-2 dans BioQ renvoie 8 voisins Swiss-Prot, avec des scores cosinus allant de 1,0 à 0,9992. Les données datent du 2026-11-06. Le moteur a mis 0,45 seconde au total, pour 2 requêtes.
Ce que nous avons demandé : une recherche d'homologie protéique par embedding ESM-2
La tâche est courante. Vous disposez d'une protéine et vous voulez savoir si Swiss-Prot contient des protéines apparentées. Une recherche par séquence est souvent l'outil le plus évident. Un modèle de langage de protéines offre un second point de vue : chaque entrée Swiss-Prot devient un point dans l'espace des embeddings, et vous listez les points les plus proches du vôtre.
Cet exemple repose sur une protéine publique et bien connue, afin que vous puissiez vérifier chaque ligne du résultat. La requête est l'accession UniProt P69905, la sous-unité alpha de l'hémoglobine humaine (nom d'entrée HBA_HUMAN). Nous demandons les 8 protéines Swiss-Prot les plus proches dans l'espace ESM-2. Nous récupérons aussi les fiches UniProt du gène HBA1, pour lire la liste des voisins à côté d'entrées curées.
Ce que BioQ a renvoyé
Le bloc des voisins utilise les embeddings ESM-2 650M de Swiss-Prot. Il affiche 8 lignes. La première est la requête elle-même, ce qui est attendu : le point le plus proche de n'importe quelle protéine est cette protéine.
| Numéro d'accession UniProt | Similarité cosinus |
|---|---|
| P69905 | 1 |
| P69906 | 1 |
| P69907 | 1 |
| Q9TS35 | 0.9996 |
| P01923 | 0.9995 |
| P63107 | 0.9992 |
| P63108 | 0.9992 |
| P67817 | 0.9992 |
Trois accessions obtiennent 1,0 : P69905, P69906 et P69907. Viennent ensuite Q9TS35 à 0,9996, P01923 à 0,9995, puis P63107, P63108 et P67817 à 0,9992. La remarque de l'outil s'applique ici : un cosinus est élevé pour presque toutes les protéines, il sert donc à classer les voisins et n'est pas un pourcentage d'identité.
Le second bloc s'appuie sur UniProt pour le gène HBA1. Il contient 26 enregistrements Swiss-Prot ; les premières lignes figurent ci-dessous.
| Numéro d'accession | Nom de l'entrée | Longueur (aa) |
|---|---|---|
| P69905 | HBA_HUMAN | 142 |
| P01946 | HBA_RAT | 142 |
| P83270 | HBA1_ANAMI | 143 |
| Q1AGS5 | HBA1_ARCGL | 143 |
| Q1AGS9 | HBA1_BORSA | 143 |
Ici, P69905 correspond à HBA_HUMAN, avec 142 résidus, et l'entrée de rat P01946 (HBA_RAT) compte elle aussi 142 résidus. Les trois entrées suivantes, issues d'autres espèces, font 143 résidus. C'est un contrôle de cohérence rapide : la famille attendue d'après le nom du gène est bien présente dans UniProt, avec des longueurs proches de celle de votre requête.
Interprétation et lecture des résultats
Lisez le classement, pas la valeur. Tous les scores se situent entre 0,9992 et 1,0 : la valeur absolue apporte donc très peu d'information. Ce qui compte, c'est l'ordre et l'endroit où la liste décroche. Une liste plate de scores quasi identiques, comme celle-ci, indique seulement que ces protéines sont proches de la requête par rapport au reste de Swiss-Prot. Elle ne dit pas à quel point elles le sont en termes d'identité de séquence.
Vérifiez chaque voisin dans sa fiche UniProt. Le tableau des voisins ne donne que des accessions. Ouvrez P69906, P69907, Q9TS35, P01923, P63107, P63108 et P67817, puis lisez le nom de la protéine, l'organisme et l'annotation de famille. Les données dont nous disposons n'indiquent pas ce que sont ces entrées : ne le supposez donc pas. Si la plupart des voisins appartiennent à la même famille que votre requête, cela appuie un lien au niveau de la famille. Si l'un d'eux n'a aucun rapport par son nom et sa fonction, considérez-le comme une piste à tester, pas comme un résultat.
MMseqs2 et ESM-2. Les outils d'alignement comme MMseqs2 rapportent, pour chaque hit, l'identité, la couverture et une E-value, et vous pouvez examiner l'alignement lui-même. Les embeddings d'un modèle de langage de protéines fonctionnent autrement. Ils comparent des représentations apprises de séquences entières, et peuvent donc rapprocher des protéines même quand le signal d'alignement est faible. C'est pourquoi on les utilise pour l'homologie lointaine. Les deux approches sont complémentaires. Ce résultat ne les compare pas sur votre protéine : lancez donc les deux lorsque la question est importante, et regardez où elles concordent.
La voie manuelle face à une seule requête. À la main, cette tâche suppose de chercher l'accession dans UniProt, de trouver ou de générer les embeddings de Swiss-Prot, de calculer les similarités, puis de retourner dans UniProt pour lire chaque voisin. Ici, une seule requête, P69905, a atteint 2 ressources distinctes : l'index d'embeddings ESM-2 de Swiss-Prot et UniProt. Le temps moteur a été de 0,45 seconde au total. Ce chiffre ne concerne que le moteur. Il n'inclut pas le temps que vous passez à lire les résultats, et nous n'affirmons rien sur la durée de la voie manuelle.
Comment reproduire l'analyse dans BioQ
- Ouvrez BioQ et collez l'accession UniProt dans la zone de recherche. Pour votre propre protéine, utilisez son accession Swiss-Prot. Si vous n'avez qu'une nouvelle séquence, l'approche par plus proches voisins exige une accession déjà présente dans l'index.
- Lancez la requête ci-dessous telle quelle.
P69905Ouvrir cette requête dans BioQ
- Lisez d'abord le tableau des voisins. Repérez l'endroit où les valeurs de cosinus commencent à baisser, et notez toute accession que vous ne reconnaissez pas.
- Ouvrez les fiches UniProt des accessions inconnues. Comparez le nom, l'organisme et la longueur avec ceux de votre requête.
- Si un voisin vous semble intéressant, lancez une recherche par alignement de séquences, par exemple avec MMseqs2, sur cette paire pour obtenir l'identité et une E-value. Interrogez ensuite BioQ sur le gène du voisin pour voir ce que disent les autres couches de données.
Chaque réponse de BioQ indique sa source : le tableau que vous exportez mentionne donc la version des embeddings (embeddings ESM-2 650M de Swiss-Prot) et l'origine UniProt des enregistrements.
Limites : ce que les données ne montrent pas
- Une similarité cosinus n'est pas une identité de séquence, ni une probabilité d'homologie. Dans cet exemple, tous les scores sont très élevés : un seuil sur la valeur brute ne séparerait pas les protéines apparentées des non apparentées.
- La liste présente 8 voisins parce que c'est ce qui a été demandé. Elle n'indique pas combien de protéines Swiss-Prot sont apparentées à votre requête, et une protéine située juste hors de la liste peut très bien l'être aussi.
- L'embedding ne couvre que Swiss-Prot. Une protéine apparentée absente de Swiss-Prot ne peut pas apparaître.
- Le résultat ne renseigne ni sur la fonction, ni sur la structure, ni sur le sens de l'évolution. Des embeddings similaires peuvent refléter des domaines partagés, une composition proche ou l'appartenance à une même famille, et le tableau ne précise pas laquelle de ces raisons s'applique.
- L'hémoglobine alpha appartient à une famille très étudiée et fortement conservée. Une protéine moins caractérisée peut donner une liste plus plate, plus difficile à interpréter, et cet exemple ne permet pas de prédire le comportement de la vôtre.
- Les 26 enregistrements UniProt pour HBA1 correspondent au nombre d'entrées renvoyées pour ce nom de gène. Ce n'est pas une mesure du nombre de protéines distinctes de la famille.
- Les chiffres reflètent les données au 2026-11-06. Des versions ultérieures d'UniProt ou des embeddings peuvent modifier la liste.
Données et méthode
Les chiffres de cette page ont été lus dans le moteur BioQ le 2026-11-06 (2 requêtes, 0.5 s de temps moteur au total). Les tableaux sont générés par du code à partir des réponses du moteur ; le texte ne fait que les expliquer.
/neighbourhood, /uniprot
Exécutez vous-même la même requête dans BioQ : P69905
À usage de recherche uniquement. Cette page résume des données publiques et ne constitue pas un avis médical.
BioQ est un moteur de recherche IA et un agent dont l'objectif est de rendre la recherche en biologie 100 fois plus rapide. Interrogez-le dans l'application web, via l'API REST ou depuis Claude, ChatGPT ou Cursor grâce à MCP.
Requêtes utilisées
Questions fréquentes
Comment trouver des protéines apparentées à ma protéine avec les embeddings ESM-2 ?
Saisissez l'accession Swiss-Prot, par exemple P69905, dans BioQ. L'outil renvoie les protéines Swiss-Prot les plus proches dans l'espace ESM-2 ; cet exemple en a renvoyé 8, avec des valeurs de cosinus de 1,0 à 0,9992.
La valeur de cosinus est-elle équivalente à un pourcentage d'identité ?
Non. Le cosinus ne fait que classer les voisins, et il est élevé pour presque toutes les protéines. Dans cet exemple, les 8 valeurs se situent entre 0,9992 et 1,0 : pour connaître l'identité, il faut un outil d'alignement.
En quoi une recherche de voisins ESM-2 diffère-t-elle de MMseqs2 ?
MMseqs2 aligne les séquences et rapporte l'identité et une E-value. La recherche ESM-2 compare des embeddings appris, ce qui peut révéler une homologie lointaine. Cet exemple ne compare pas les deux sur votre protéine : vérifiez donc les voisins prometteurs par un alignement.
Combien de temps la requête P69905 a-t-elle pris ?
Le temps moteur a été de 0,45 seconde au total, pour 2 requêtes portant sur 2 ressources distinctes. Il s'agit du temps moteur uniquement, pas du temps de lecture.
Combien d'enregistrements UniProt HBA1 compte-t-il dans ce résultat ?
Le bloc UniProt liste 26 enregistrements Swiss-Prot pour le gène HBA1. L'entrée humaine P69905 (HBA_HUMAN) fait 142 résidus.
Sources
- Jeu de données UniProtKB/Swiss-Prot with ESM-2 embeddings
Les résultats proviennent de bases de données publiques à la date indiquée et peuvent changer. BioQ fournit des informations de recherche, pas des conseils médicaux.
Autres articles
Dépendance à MDM2 et MDM4 : gènes et médicaments
Dépendance à MDM2 et MDM4 dans DepMap 24q4 (Chronos) : 384 lignées sur 1178 dépendent de MDM2, 142 de MDM4 ; 12 médicaments annotés pour MDM2, 1 pour MDM4.
Approbation FDA du tiratricol : cibles et puissance
Approbation FDA du tiratricol : ChEMBL recense 68 cibles, THRB et THRA en tête par pChEMBL, et 3 essais cliniques sur ClinicalTrials.gov au 2026-11-17.
Nouvelle étude sur CD4 : CAR-NK et rebond du VIH
Nouvelle étude sur CD4 (CAR-NK, rebond du VIH) mise en contexte avec BioQ : dépendance DepMap, maladies Open Targets, médicaments et voies Reactome.