

ESM-2 임베딩 단백질 상동성 검색: P69905
P69905(hemoglobin alpha)의 ESM-2 이웃 단백질 8개를 코사인 점수와 UniProt 기록으로 봅니다. 2026-11-06 기준.
데이터 기준일 2026년 11월 6일 · BioQ 팀
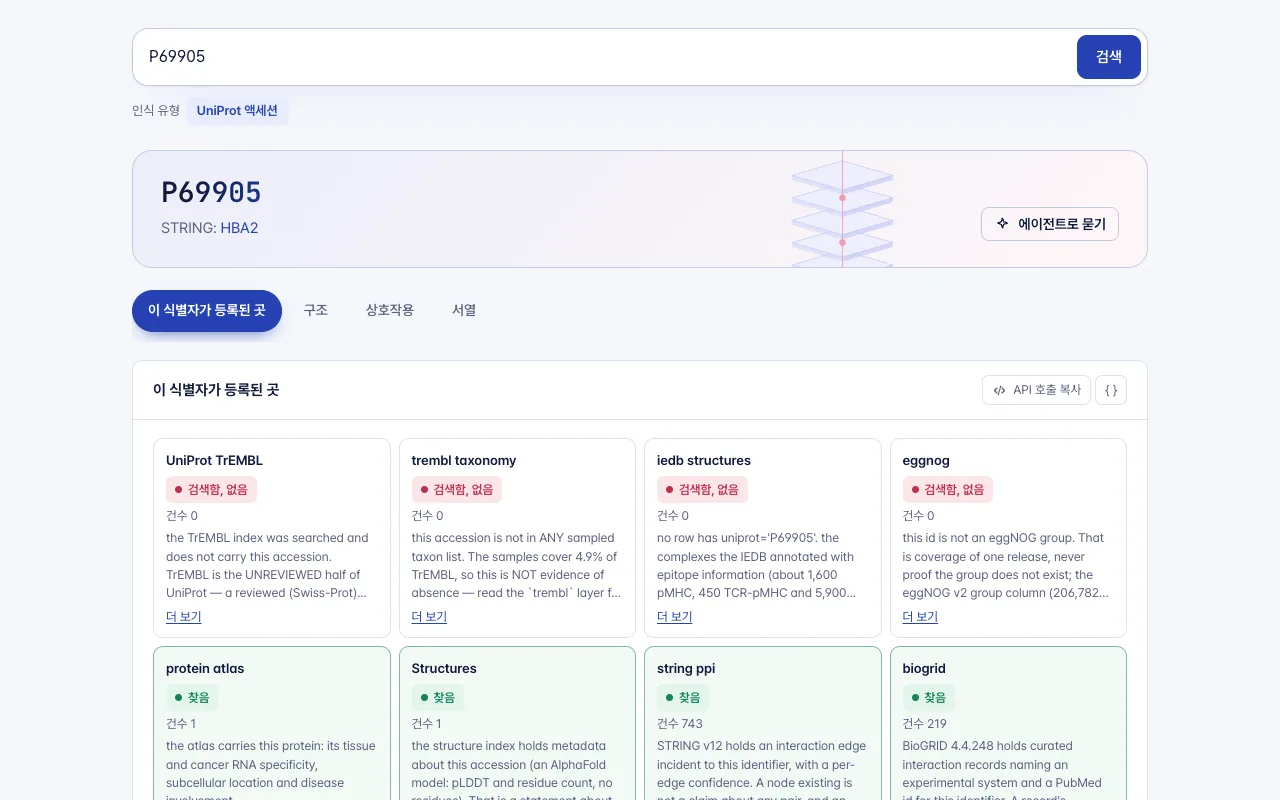
P69905(hemoglobin alpha)로 BioQ에서 ESM-2 임베딩 단백질 상동성 검색을 하면 Swiss-Prot 이웃 단백질 8개가 나옵니다. 코사인 점수는 1.0에서 0.9992까지입니다. 데이터는 2026-11-06 기준입니다. 엔진 시간은 쿼리 2건을 합쳐 총 0.45초였습니다.
질문: ESM-2 임베딩 단백질 상동성 검색으로 무엇을 찾나
흔히 하는 작업입니다. 단백질이 하나 있고, Swiss-Prot에 관련 단백질이 있는지 알고 싶습니다. 보통은 서열 검색이 먼저 떠오릅니다. 단백질 언어 모델은 다른 관점을 줍니다. Swiss-Prot의 각 항목을 임베딩 공간의 한 점으로 보고, 내 단백질과 가장 가까운 점을 나열합니다.
이 예시는 결과를 한 줄씩 확인할 수 있도록 널리 알려진 공개 단백질을 씁니다. 쿼리는 UniProt accession P69905이며, 사람 hemoglobin subunit alpha(entry name HBA_HUMAN)입니다. ESM-2 공간에서 가장 가까운 Swiss-Prot 단백질 8개를 요청했습니다. 유전자 HBA1의 UniProt 기록도 함께 가져왔습니다. 이웃 목록을 큐레이션된 항목과 나란히 읽기 위해서입니다.
BioQ가 돌려준 결과
이웃 블록은 Swiss-Prot의 ESM-2 650M 임베딩을 사용합니다. 모두 8행이 나옵니다. 첫 행은 쿼리 자신입니다. 어떤 단백질이든 가장 가까운 점은 자기 자신이므로 예상한 결과입니다.
| UniProt 수탁 번호 | 코사인 유사도 |
|---|---|
| P69905 | 1 |
| P69906 | 1 |
| P69907 | 1 |
| Q9TS35 | 0.9996 |
| P01923 | 0.9995 |
| P63107 | 0.9992 |
| P63108 | 0.9992 |
| P67817 | 0.9992 |
accession 세 개가 1.0입니다. P69905, P69906, P69907입니다. 그다음은 Q9TS35가 0.9996, P01923이 0.9995, P63107, P63108, P67817이 0.9992입니다. 도구의 주석대로 코사인 값은 거의 모든 경우에 높게 나옵니다. 이웃의 순위를 매기는 값이지 서열 동일성(%)이 아닙니다.
두 번째 블록은 유전자 HBA1에 대한 UniProt 정보입니다. Swiss-Prot 기록은 26건이며, 앞부분 몇 행은 아래와 같습니다.
| 수탁 번호 | 엔트리 이름 | 길이 (aa) |
|---|---|---|
| P69905 | HBA_HUMAN | 142 |
| P01946 | HBA_RAT | 142 |
| P83270 | HBA1_ANAMI | 143 |
| Q1AGS5 | HBA1_ARCGL | 143 |
| Q1AGS9 | HBA1_BORSA | 143 |
P69905는 HBA_HUMAN이며 길이는 142 잔기입니다. 쥐 항목 P01946(HBA_RAT)도 142 잔기입니다. 이어지는 세 항목은 다른 종의 것이며 143 잔기입니다. 간단한 정합성 확인이 됩니다. 유전자 이름에서 기대하는 패밀리가 UniProt에 있고, 길이도 쿼리와 비슷합니다.
결과의 의미와 해석 방법
숫자가 아니라 순위를 읽으십시오. 점수가 모두 0.9992에서 1.0 사이에 있어 절댓값은 정보가 거의 없습니다. 의미 있는 것은 순서와 목록에서 값이 떨어지는 지점입니다. 이 예시처럼 거의 같은 점수가 이어지면, 이 단백질들이 Swiss-Prot 나머지에 비해 쿼리와 가깝다는 것만 알 수 있습니다. 서열 동일성이 얼마나 되는지는 알 수 없습니다.
이웃마다 UniProt 항목에서 확인하십시오. 이웃 표에는 accession만 있습니다. P69906, P69907, Q9TS35, P01923, P63107, P63108, P67817을 열어 단백질 이름, 생물종, 패밀리 주석을 읽어 보십시오. 이 항목들이 무엇인지는 여기 제시된 데이터에 없으므로 추측하지 않아야 합니다. 대부분의 이웃이 쿼리와 같은 패밀리라면 패밀리 수준의 연관성을 뒷받침합니다. 이름과 기능이 무관한 이웃이 하나 있다면 발견이 아니라 검증할 단서로 다루십시오.
MMseqs2와 ESM-2의 차이. MMseqs2 같은 정렬 도구는 hit마다 동일성, 커버리지, E-value를 보고하며 정렬 자체를 확인할 수 있습니다. 단백질 언어 모델 임베딩은 방식이 다릅니다. 서열 전체의 학습된 표현을 비교하므로 정렬 신호가 약해도 서로 가까운 위치에 놓일 수 있습니다. 먼 상동성(remote homology)에 쓰는 이유입니다. 두 방법은 서로 보완합니다. 이 결과는 두 방법을 내 단백질에서 비교한 것이 아닙니다. 중요한 질문이라면 둘 다 돌려 어디서 일치하는지 보십시오.
수작업과 쿼리 한 번의 비교. 직접 하면 UniProt에서 accession을 찾고, Swiss-Prot 임베딩을 구하거나 생성하고, 유사도를 계산한 뒤, 다시 UniProt로 돌아가 이웃을 하나씩 읽어야 합니다. 여기서는 쿼리 P69905 하나로 서로 다른 자원 2곳에 닿았습니다. Swiss-Prot의 ESM-2 임베딩 인덱스와 UniProt입니다. 엔진 시간은 총 0.45초였습니다. 이는 엔진 시간일 뿐 결과를 읽는 시간은 포함하지 않으며, 수작업에 걸리는 시간에 대해서는 어떤 주장도 하지 않습니다.
BioQ에서 재현하는 방법
- BioQ를 열고 검색창에 UniProt accession을 붙여 넣습니다. 내 단백질이라면 Swiss-Prot accession을 쓰십시오. 새 서열만 있다면, 최근접 이웃 방식은 인덱스에 이미 있는 accession이 필요합니다.
- 아래 쿼리를 그대로 실행합니다.
P69905- 이웃 표를 먼저 읽습니다. 코사인 값이 떨어지기 시작하는 지점과, 낯선 accession이 있는지 확인합니다.
- 낯선 accession은 UniProt 기록을 열어 이름, 생물종, 길이를 쿼리와 비교합니다.
- 흥미로운 이웃이 있으면 그 쌍에 MMseqs2 같은 서열 정렬 검색을 돌려 동일성과 E-value를 얻습니다. 이어서 BioQ에 그 이웃의 유전자를 물어 다른 데이터 계층이 무엇을 말하는지 확인합니다.
BioQ의 모든 답변에는 출처가 표시됩니다. 내보낸 표에는 임베딩 릴리스(Swiss-Prot의 ESM-2 650M 임베딩)와 기록의 UniProt 출처가 함께 담깁니다.
한계: 데이터가 보여 주지 않는 것
- 코사인 유사도는 서열 동일성이 아니며, 상동성의 확률도 아닙니다. 이 예시에서는 모든 점수가 매우 높아서, 원래 값에 기준선을 두면 관련 단백질과 무관한 단백질을 가를 수 없습니다.
- 목록의 이웃이 8개인 것은 8개를 요청했기 때문입니다. Swiss-Prot에서 내 쿼리와 관련된 단백질이 몇 개인지는 보여 주지 않으며, 목록 바로 밖의 단백질도 관련이 있을 수 있습니다.
- 임베딩은 Swiss-Prot만 다룹니다. Swiss-Prot에 없는 관련 단백질은 나타날 수 없습니다.
- 결과로는 기능, 구조, 진화의 방향을 알 수 없습니다. 임베딩이 비슷한 것은 공유 도메인, 조성, 패밀리 소속을 반영할 수 있으나 표는 그중 무엇인지 알려 주지 않습니다.
- Hemoglobin alpha는 연구가 많이 된, 보존성이 높은 패밀리입니다. 특성이 덜 밝혀진 단백질은 더 평탄하고 해석하기 어려운 목록을 줄 수 있으며, 이 예시로는 내 단백질이 어떻게 나올지 알 수 없습니다.
- HBA1의 UniProt 기록 26건은 그 유전자 이름으로 반환된 항목 수입니다. 패밀리에 서로 다른 단백질이 몇 종 있는지를 나타내는 값이 아닙니다.
- 수치는 2026-11-06 기준 데이터입니다. 이후 UniProt나 임베딩 릴리스가 바뀌면 목록도 달라질 수 있습니다.
데이터와 방법
이 글의 숫자는 2026-11-06에 BioQ 엔진에서 읽었습니다(질의 2건, 엔진 처리 시간 합계 0.5초). 표는 엔진 응답으로 코드가 만들었고, 본문은 그 값을 풀어 쓴 것입니다.
/neighbourhood, /uniprot
같은 질의를 BioQ에서 직접 실행해 보세요: P69905
연구 참고용입니다. 공개 데이터를 정리한 글이며 의료 조언이 아닙니다.
BioQ는 생물학 연구를 100배 빠르게 만드는 것을 목표로 하는 AI 검색엔진이자 에이전트입니다. 웹 앱과 REST API로 물어볼 수 있고, MCP로 Claude·ChatGPT·Cursor에서도 쓸 수 있습니다.
사용한 질의
자주 묻는 질문
ESM-2 임베딩으로 내 단백질과 관련된 단백질을 찾으려면 어떻게 합니까?
BioQ에 P69905 같은 Swiss-Prot accession을 입력합니다. ESM-2 공간에서 가장 가까운 Swiss-Prot 단백질이 나옵니다. 이 예시에서는 8개가 나왔고 코사인 값은 1.0에서 0.9992까지였습니다.
코사인 값은 서열 동일성(%)과 같습니까?
아닙니다. 코사인은 이웃의 순위만 매기며, 거의 모든 경우에 높게 나옵니다. 이 예시에서도 8개 값이 모두 0.9992에서 1.0 사이이므로, 동일성은 정렬 도구로 확인해야 합니다.
ESM-2 이웃 검색은 MMseqs2와 무엇이 다릅니까?
MMseqs2는 서열을 정렬해 동일성과 E-value를 보고합니다. ESM-2 검색은 학습된 임베딩을 비교하므로 먼 상동성을 잡아낼 수 있습니다. 이 예시는 두 방법을 내 단백질에서 비교하지 않았으니, 유망한 이웃은 정렬로 확인하십시오.
P69905 쿼리에는 시간이 얼마나 걸렸습니까?
엔진 시간은 총 0.45초였고, 서로 다른 자원 2곳을 쓴 쿼리 2건입니다. 엔진 시간만 센 값이며 결과를 읽는 시간은 들어 있지 않습니다.
이 결과에서 HBA1의 UniProt 기록은 몇 건입니까?
UniProt 블록에는 유전자 HBA1의 Swiss-Prot 기록이 26건 나옵니다. 사람 항목 P69905(HBA_HUMAN)의 길이는 142 잔기입니다.
출처
결과는 표시된 날짜의 공개 데이터베이스 기준이며 바뀔 수 있습니다. BioQ는 연구 정보를 제공하며 의학적 조언이 아닙니다.
블로그의 다른 글
MDM2 vs MDM4 비교: 암 세포주 의존성과 약물
MDM2 vs MDM4 비교: DepMap 24q4에서 1178개 세포주 중 MDM2 의존 384개, MDM4 142개. 약물은 MDM2 12개, MDM4 1개.
tiratricol FDA 승인: BioQ 표적·활성 데이터
tiratricol FDA 승인(Emcitate): ChEMBL 표적 68개, THRB·THRA 최고 pChEMBL, 임상시험 3건. 2026-11-17 기준 데이터입니다.
CD4 최신 연구: CAR-NK 세포와 HIV 재발 맥락
CD4 기반 CAR-NK 논문을 BioQ의 CD4 데이터(DepMap 의존성, Open Targets 질환, 약물, Reactome 경로)와 함께 살펴봅니다.